我把「AI星辰电台」新闻播客生成器 Skill 开源了
今天原本差点要断更。我的工作日音频节目一直有一个相对固定的生产方式:每天选 3 到 5 条 AI 治理和数据合规新闻,生成一段适合通勤时听完的音频,再配一份 Shownotes。它解决的其实是一个很朴素的需求:很多重要资讯本来是文字,但并不是每个人都有整块时间坐下来读;对于习惯听播客、听课程、听新闻的人来说,把文字材料转成一段结构清楚的音频,反而更容易利用通勤、散步、排队这些碎片时间。过去这件事主要放在 YouMind 里完成,而且不是每次临时写提示词,而是我已经在 YouMind 里做了一个「AI星辰电台节目生成器」Skill。这个 Skill 也不是一开始就长这样,它最早来自我用 ChatGPT 生成的一套提示词,后来根据节目的真实需求,慢慢加上新闻读取规则、脚本结构、Shownotes 样式、标签格式、音色配置和质量检查,最后才变成 YouMind 里的固定工作流。
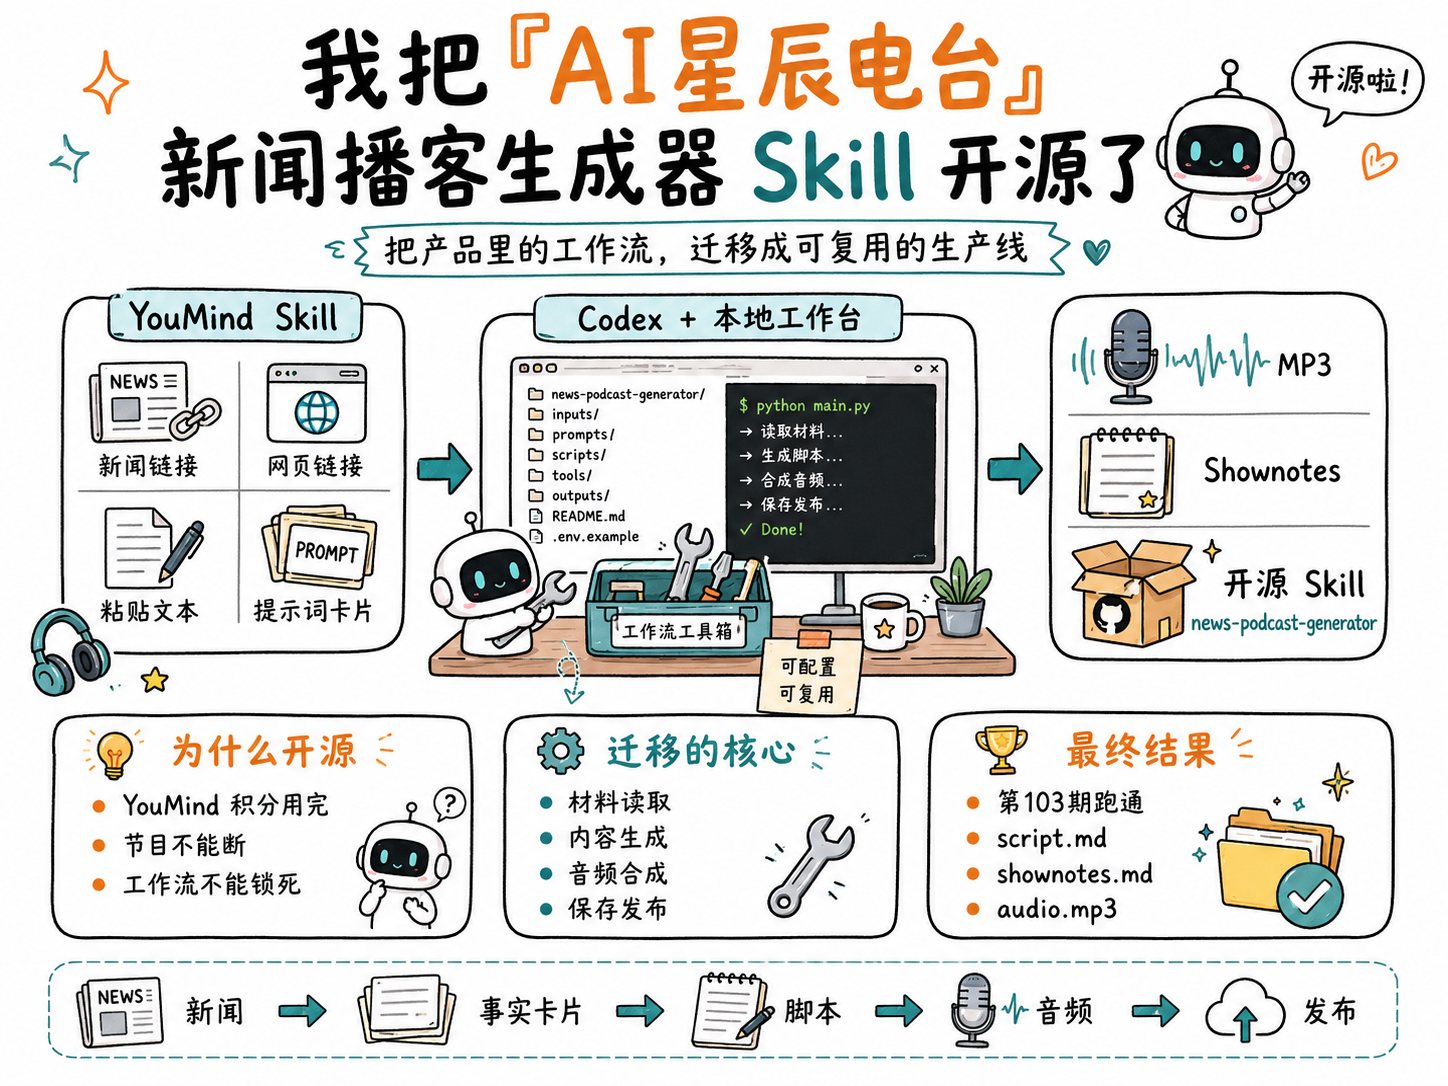
所以,今天 YouMind 积分用完时,真正让我犹豫的不是“要不要续费”,而是另一个问题:这套已经沉淀出来的工作方法,能不能从具体产品里拿出来?如果它只能存在于 YouMind 的按钮和积分体系里,那我拥有的其实不是一条内容生产线,而是一个平台里的操作习惯。反过来,如果它能被 Codex 读懂、拆解,再迁移成本地脚本和通用 Skill,那么即便某个付费产品暂时不可用,节目本身也不必跟着中断。
这就是今天这件事真正有意思的地方。我不是让 Codex 从零发明一个“播客助手”,而是把 YouMind 里已经跑过一段时间的 Skill 文本交给它,让它分析这套 Skill 到底由哪些能力组成,哪些能力依赖 YouMind,哪些能力只是流程、结构和提示词,哪些部分可以换成本地文件、命令行脚本和免费的 TTS 服务。最后我们不但生成了第 103 期的 Shownotes 和 MP3,还把这个流程整理成了一个去品牌化的开源 Skill:news-podcast-generator。
真正迁移的不是工具界面,而是 Skill 里的生产逻辑
我给 Codex 的原始材料,是一份相当完整的 YouMind Skill。它规定了怎样处理 3 到 5 条新闻,怎样读取 YouMind material、YouMind 链接、外部网页 URL 和用户粘贴文本;每条新闻要提取标题、发布日期、来源机构、核心事实、影响范围和原始 URL;播客脚本要有固定开场、逐条新闻解读和自然收束;Shownotes 要包含节目导航、主编深度洞察、延伸阅读和标签;最后还有一组质量自检,检查事实准确性、音频时长、标签格式和敏感表达边界。
这些东西看起来像提示词,但本质上已经是一个微型生产系统。尤其是对日更内容来说,价值往往不在某一句“请你写得专业但口语化”,而在那些被反复打磨出来的边界条件:哪些材料可以进入流程,遇到无法访问的材料要怎么停下来,事实复述和企业启示之间怎么分层,Shownotes 末尾的标签为什么不能写成 # AI治理,而必须写成 #AI治理。这些细节很小,但它们决定了一个节目能不能稳定输出。
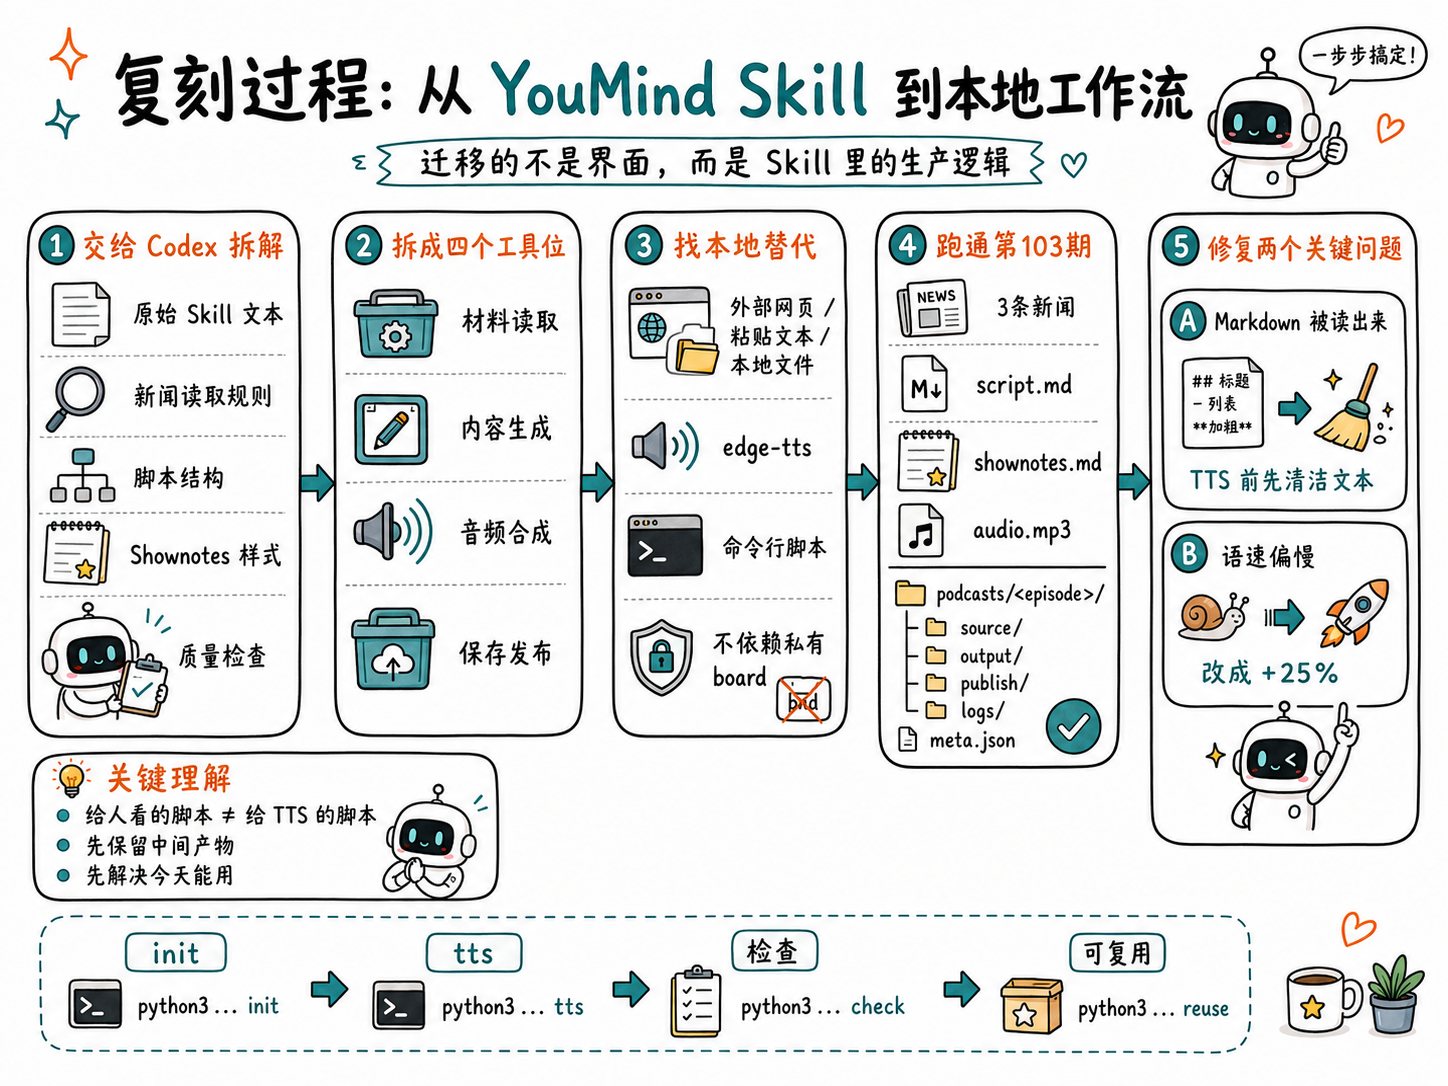
Codex 读完之后,做的第一件事不是写稿,而是拆模块。它把原来的 YouMind Skill 拆成四个工具位:材料读取、内容生成、音频合成、保存与发布。材料读取原来依赖 YouMind 的 read、fetch 等工具;音频合成原来依赖 audioGenerate 和指定女声;保存阶段还可能写回 YouMind board。相比之下,事实抽取、播客脚本、Shownotes 和质量检查,更多是结构化提示词和写作流程,不必绑定 YouMind。
拆到这里,替代路线就很清楚了。YouMind 私有 board 里的 material 读取能力不能直接复刻,特定音色也不能完全复制,但外部网页、粘贴文本、本地文件、PDF、Markdown 都可以进入本地目录;脚本和 Shownotes 可以继续由 Codex 按原来的结构生成;音频合成先换成免费的 edge-tts;保存回 YouMind 不是刚需,所以从第一版里拿掉。也就是说,我们没有去仿一个 YouMind 界面,而是把原 Skill 的操作语义改写成了本地文件结构和命令行流程。
第一版只解决一个问题:今天的节目不能断
我没有一开始就要求它做成完整产品。第一版只追求一件事:今天这期节目可以生成 Shownotes 和 MP3。Codex 在本地工作台里加了一个 podcast_workbench.py,用来初始化节目目录、记录元数据、清洁 TTS 输入、调用 TTS、以及在未来需要时生成 RSS。目录结构很朴素,但足够清楚:
对应命令也很直接:
我给了三条新闻链接,分别来自澳大利亚网络安全中心、韩国个人信息保护委员会和佛罗里达州总检察长办公室。Codex 先确认来源页面可以访问,再判断三条材料分别落在 AI 网络防御、个人信息泄露预防、AI 产品消费者保护诉讼上。这里也顺便校准了节目的主题边界:它不是只做 AI 监管,而是同时覆盖 AI 治理和数据合规,所以韩国 PIPC 那条虽然没有直接写 AI,但属于典型的数据合规新闻,应该正常进入节目。
第一次跑出来以后,音频其实已经能听,但有两个地方马上暴露出来。第一个问题是 TTS 把 Markdown 标题里的 # 也读出来了。原因很简单:script.md 是给人看的 Markdown 文件,而 TTS 需要的是清洁后的口播文本。如果直接把 Markdown 喂进去,标题符号、链接格式、加粗标记都可能进入音频。于是我让 Codex 在 TTS 前加了清洁步骤:去掉标题符号、列表符号、加粗和代码标记,把 标题 还原成标题,同时保留自然段落。第二个问题是语速偏慢,我让它把 edge-tts 的默认语速改成 +25%,也就是大约 1.25 倍。重新生成后,节奏就接近日常新闻播客了。
这两个调整很小,但它们说明了把 Skill 迁移成本地工具时最容易被忽略的地方:同一份内容在不同环节里不是同一种文本。给人看的脚本可以保留 Markdown,给 TTS 的脚本必须清洁,给 RSS 的 Shownotes 要适合 XML,给公众号的文章还要考虑标题、摘要、封面和链接占位。工作流真正稳定,不是因为某个模型一次写得好,而是因为每个环节的输入输出都被处理对了。
这个开源 Skill 的原理:把“新闻到音频”拆成五层
我后来把这个流程抽象成一个通用 Skill,核心逻辑其实很简单:把“新闻材料到音频节目”的过程,拆成可检查、可替换、可保存的中间产物。它不是一个神秘的一键生成器,而是一条分层生产线。
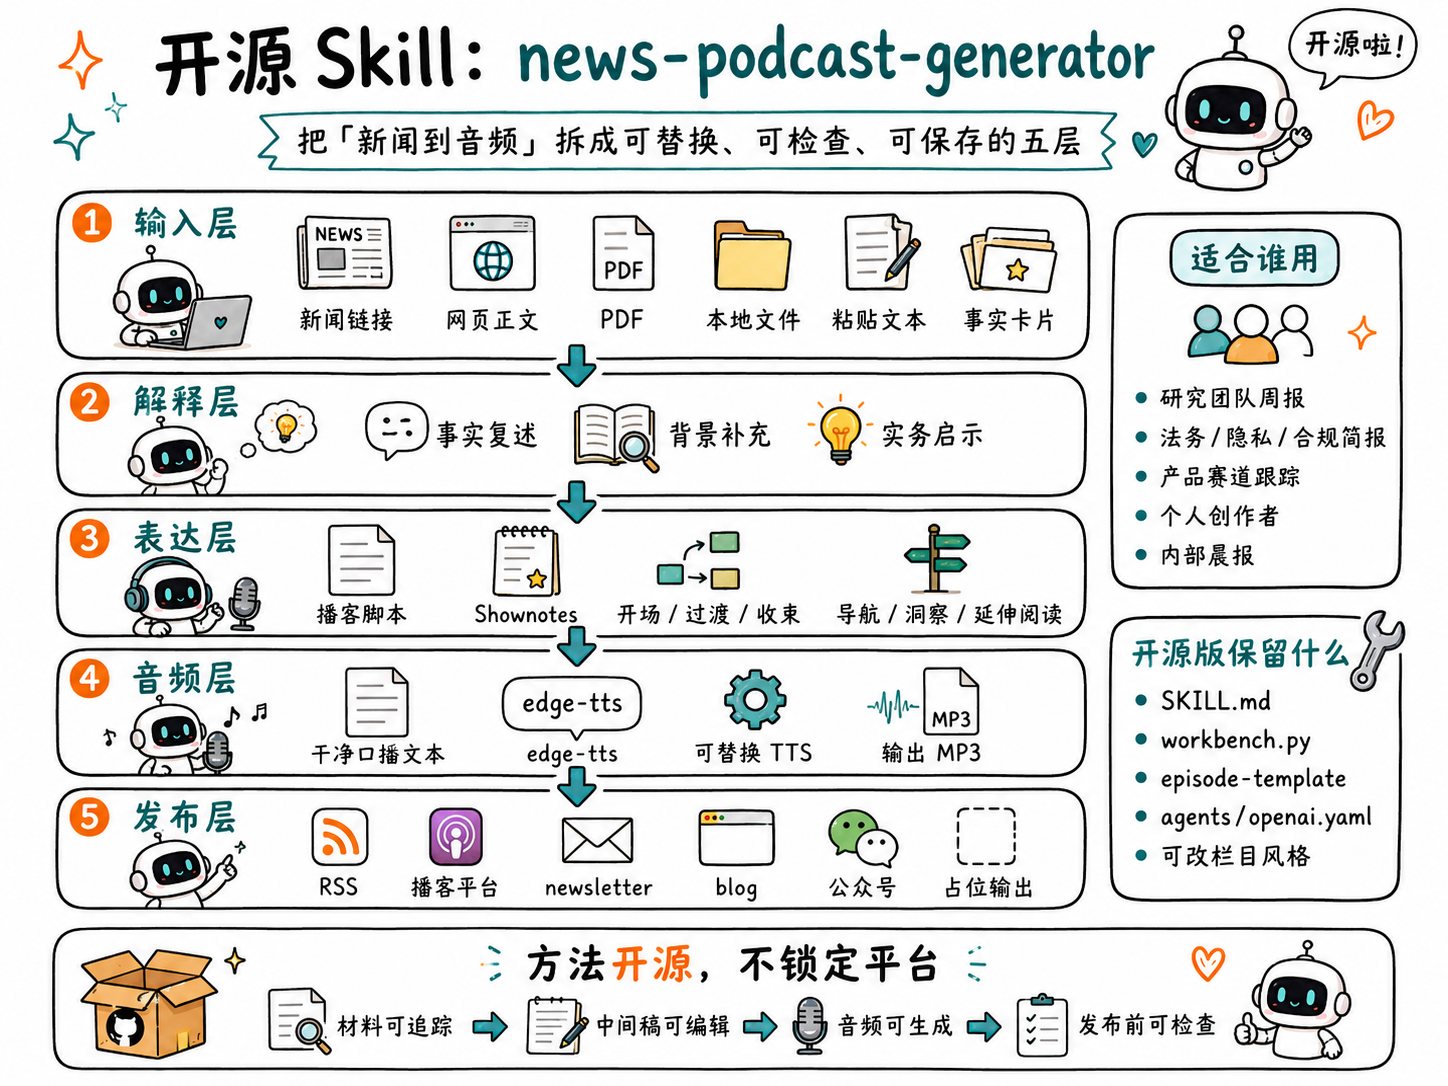
第一层是输入层。材料可以是新闻链接、网页正文、PDF、本地文件或用户粘贴文本。Skill 要求先整理事实卡片,包括标题、来源、日期、机构、核心事实、影响范围和原始 URL。这样做的目的,是让后面的脚本和洞察都能回到来源,而不是只凭模型印象发挥。第二层是解释层。每条新闻不只是摘要,而是要区分事实复述、背景补充和实务启示。这个分层很重要,因为新闻播客最容易变成“把新闻重新念一遍”,但真正对听众有价值的是解释“这件事对我意味着什么”。
第三层是表达层。同一批事实会生成两种表达:一种是可听的播客脚本,一种是可读的 Shownotes。播客脚本要有开场、过渡、节奏和收束;Shownotes 则要方便读者快速扫到节目导航、深度洞察和延伸阅读。第四层是音频层。TTS 只是一个接口,今天可以用 edge-tts,以后也可以换 Azure、腾讯云、本地开源 TTS 或其他语音服务。只要前面能提供干净口播文本,后面能输出 MP3,整个流程就不会被某一个声音服务锁死。
第五层是发布层。RSS、播客平台、视频/音频平台、newsletter、blog、公众号,都只是出口。开源版 Skill 不绑定任何一个平台,只保留通用字段和占位。这一点我刻意保留得很克制,因为不同人的发布渠道差异太大,强行把我的渠道写进去只会降低复用性。真正应该开源的是方法,不是我的栏目外壳。
它不只适合公开播客,也适合很多“轻量新闻简报”场景
我一开始做它,是为了自己的日更音频节目。但如果把场景放宽一点,这个 Skill 适合的其实不只是公开播客。它的核心价值,是把原本需要阅读的文字资讯,改造成一段可以被听完的信息流。对于音频爱好者来说,这比再多收藏几篇文章更有用;对于时间被会议、通勤和碎片任务切开的工作者来说,它也能把原来很难安排的阅读任务,转移到路上、车上、运动时或做家务时完成。只要你的工作里存在“定期收集几条材料,提炼事实,讲给某一类人听,再留下文字笔记”的任务,它都可以作为一个起点。
比如,研究团队可以用它做每周行业动态音频,把监管公告、竞争对手动作、技术更新整理成内部可听简报;法务、隐私和合规团队可以用它做数据保护或 AI 治理周报,把政策更新、执法案例和企业启示整理成 Shownotes;产品团队可以用它跟踪某个赛道的产品新闻,让 PM 在通勤或会前快速听完一组材料;投资、战略或咨询团队也可以把它改造成“晨会简报生成器”,每天把几条市场新闻转成 5 到 10 分钟的音频摘要。
它也适合个人创作者。很多人并不是缺少观点,而是卡在重复劳动上:每天复制链接、整理材料、写开场、写摘要、生成音频、再把链接放到博客或公众号里。这个 Skill 不能替代你的判断,也不应该替代人工核查,但它可以把重复的格式劳动固定下来,让你把时间花在选题、事实确认和观点校准上。
还有一个更容易被忽略的场景,是“非公开发布”。不是所有音频都要上平台。公司内部培训、项目组晨报、管理层信息同步、会议前预听材料,都可以用同样的结构生成。公开播客只是其中一种出口,本质上它解决的是“把多源文字材料变成可听、可读、可追踪的信息包”。
从个人版到开源版,我删掉了频道,保留了骨架
开源前,我让 Codex 做了一轮清理。删掉的内容包括我的节目名、公众号名称、小宇宙和视频号等具体渠道文案、微信草稿箱接口、本地凭据、私有路径、私有 board 以及针对我个人栏目写死的资源领取话术。保留的则是通用能力:初始化一期新闻播客工作区,从链接或粘贴材料整理来源,生成 script.md,生成 shownotes.md,用 edge-tts 生成 audio.mp3,在有公开 MP3 地址后生成 RSS,并准备 newsletter 或 blog 发布占位。
开源版目录大致是:
SKILL.md 负责告诉 Codex 什么时候使用这个 Skill,以及整个新闻播客生成流程如何走;news_podcast_workbench.py 负责初始化目录、清洁口播文本、调用 TTS 和生成 RSS;episode-template.md 则是每期节目可以复用的事实卡片和发布检查表。我也让 Codex 做了校验:Skill frontmatter 合法,脚本能编译,关键词扫描后没有残留我的私有渠道信息。
GitHub 链接在这里:
https://github.com/The-Data-Galaxy/news-podcast-generator
如果你想试,可以把它当成一个骨架,而不是一个成品 SaaS。最小使用方式是:
实际使用时,你还需要让 Codex 根据你的新闻材料写 output/script.md 和 output/shownotes.md。TTS 只是最后一步。如果你有自己的栏目风格,可以改开场白、新闻结构、Shownotes 模板、标签规则和发布出口。这个 Skill 的目标不是让所有人的节目都长一样,而是让大家少从零搭一遍“新闻到音频”的生产链。
我现在更在意的是:工作流能不能离开具体产品
今天这件事很小:YouMind 积分用完了,我用 Codex 做了一个替代方案。但它背后提醒我的,是一个更长期的问题。很多时候,我们以为自己依赖的是某个产品,其实依赖的是自己在那个产品里慢慢沉淀出来的工作流。这个工作流最早可能是一段 ChatGPT 提示词,后来变成 YouMind 里的 Skill,再后来也可以被 Codex 迁移成本地脚本和开源 Skill。工具在变,但关于“如何选材、如何讲述、如何生成、如何检查”的方法,才是真正应该积累的东西。
如果一个任务会长期重复,就值得把它从具体产品里抽象出来。不一定一开始就做得很完整,先让材料可追踪,中间稿可编辑,音频可生成,发布前可检查,就已经比完全依赖一个黑箱按钮更稳。今天的节目没有断更,更重要的是,以后再遇到某个工具突然不可用,我不会只剩下“等额度恢复”这一种选择。
我手里不只是一个按钮了,而是一条可以自己修、自己换零件的生产线。
说明:本文件为公众号渲染试稿,建议在浏览器中打开后复制渲染结果,再粘贴到公众号编辑器。