前段时间,法律圈里流传一个很有意思的说法:律师开源 Skill,快成黑暗森林了。
这句话乍听像玩笑。我最近顺着这个话题去 GitHub 上检索了一圈,越看越觉得,它至少抓住了一个真实变化:法律 Skill 的开源潮已经冒头,而且开始从零散项目,长出一点生态的样子。
这里说的 Skill,已经超出了简单 prompt 或传统合同模板的范围。更准确地说,它是把某类法律工作拆成可以被 AI 调用、执行或辅助完成的能力单元。一个 Skill 可以用于合同审查,也可以用于法律检索、法规数据库 MCP server、隐私政策生成、agent 工作流,或者某个更窄的法律任务切片。它背后真正有意思的地方在于,原本藏在个人经验、律所模板和项目交付里的工作方法,开始被写成代码、规则、接口、测试和工作流。
这些项目当然还很早期,质量差异也很大。有的接近可用工具,有的只是演示项目,有的更像方法论切片。可即便如此,它们已经足够提示一个方向:法律工作中那些可重复、可拆解、可验证的部分,正在变成可以公开观察、运行、比较和复用的东西。
一、先看数据:这不是几个零星项目
本文研究采用 12 个高相关人工复核样本 作为主口径。选择这个口径,是为了避免把不同检索批次里的样本数混在一起,也避免被 GitHub 上大量法律文件、课程项目、普通 legal-tech 仓库带偏。
宽口径检索先给我们一个外圈感知。GitHub 仓库搜索 legal agent,结果大约是 2.4k;legal-tech topic 接近 950;legal-ai topic 在不同检索时点大约是 307 到 347;legal-documents 约 251;contract-analysis 约 134 到 135;contract-review 约 49;legal-automation 约 17。这些数字不能简单相加,因为同一个仓库可能同时打上多个标签,里面也混着不少数据集、文件库、课程作业和宽泛的 legal-tech 项目。
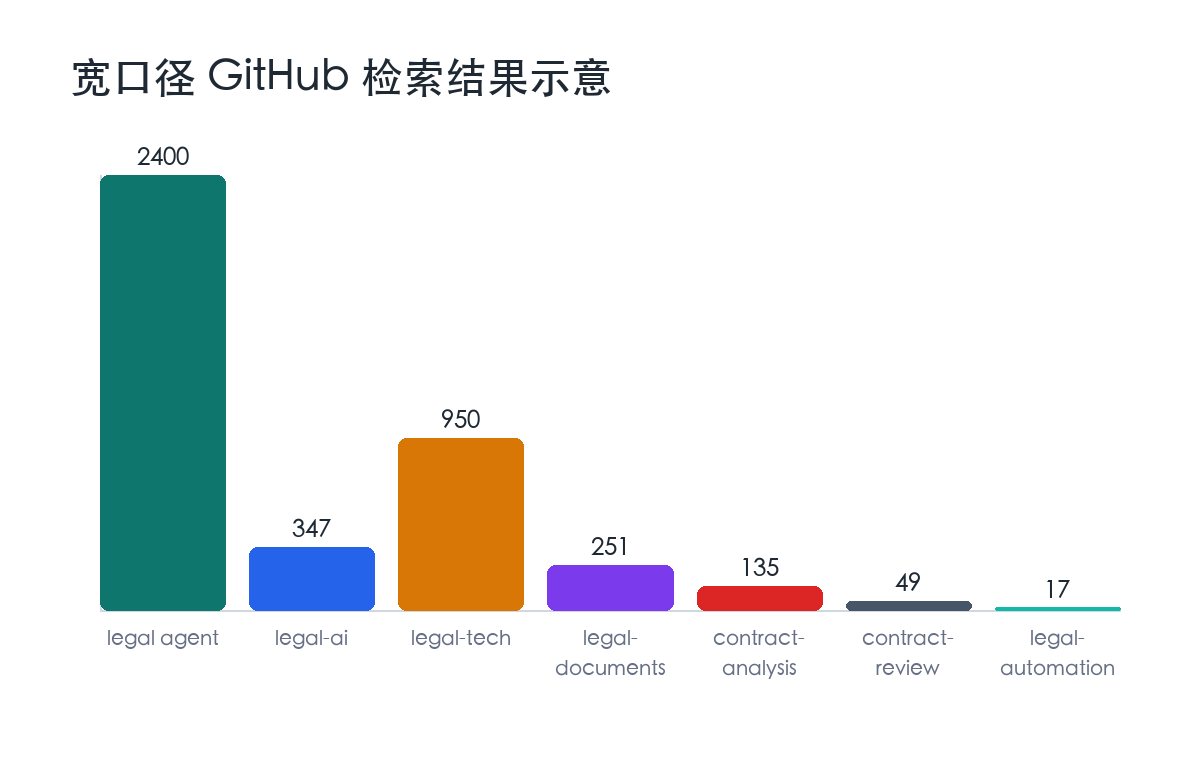
本文的核心筛选标准因此收得更窄:仓库要明确暴露出 reusable legal skill、agent、workflow、prompt/template 或 tooling layer,并且能够看出它试图把某类法律工作拆成可调用、可执行、可复核的能力单元。按照这个标准,本文研究保留了 12 个高相关人工复核样本。样本规模还谈不上成熟生态,但已经足以说明,GitHub 上确实出现了一个初步可见的 Legal Skill 开源层。
对法律工作来说,“有人开源了”还远远不够。真正值得看的,是仓库有没有运行说明、数据源、测试、许可证、边界提示、人工复核机制和清楚的输入输出。一个合同审查 Skill 如果没有说清楚法域、任务边界、适用材料、输出格式和复核要求,却把自己包装成“全自动律师”,风险往往比价值来得更快。
二、合同审查,是最拥挤的第一战场
从领域分布看,合同审查仍然是最密集的方向。这并不意外。合同审查本来就容易被结构化:合同类型识别、条款抽取、风险标签、修改建议、红线输出、风险摘要、客户版说明,这些步骤都适合被拆成流程。
在 12 个高相关样本中,合同审查与起草占 4 个,是最集中的方向;法律检索与 RAG、法源 API、MCP 数据接入占 3 个;其余分布在技能库、诉讼支持、合规隐私和实践管理连接器等方向。
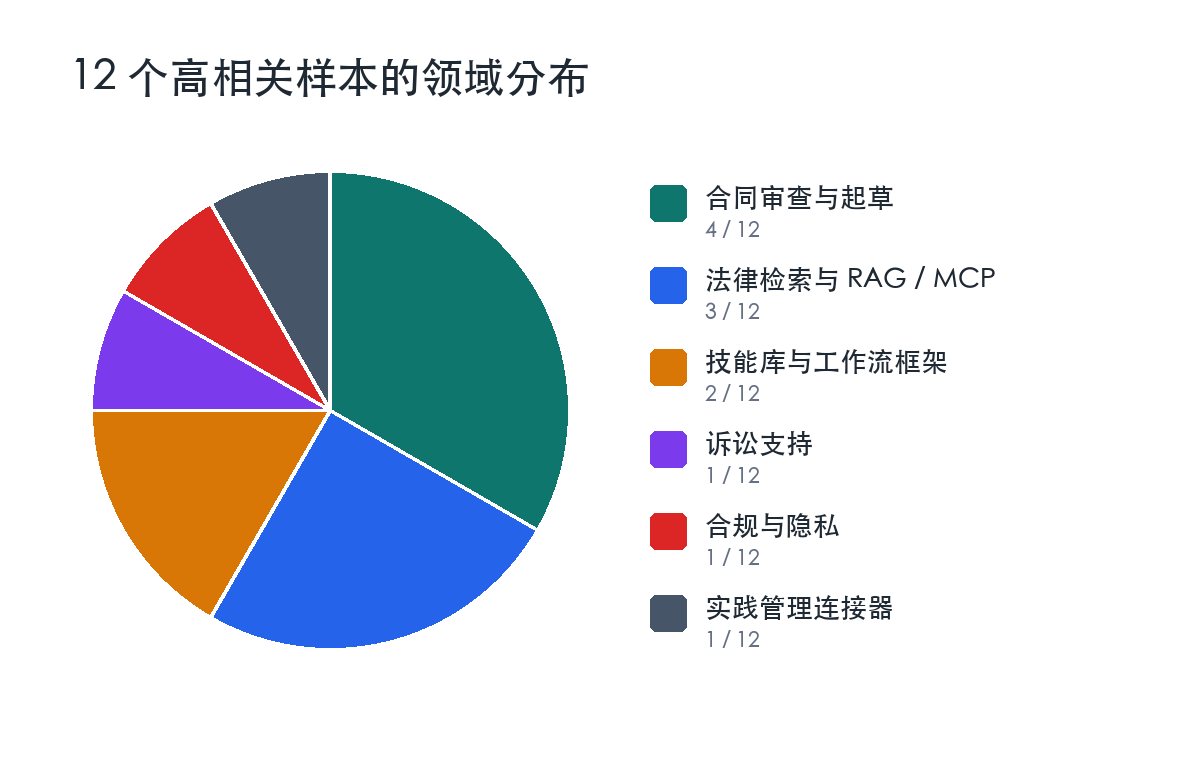
这个分布很诚实。最先被开源化、模板化、商品化的,通常是法律服务里最稳定、最重复、最容易验收的基础动作,而非整套法律服务。过去客户不一定能区分合同审查里哪些是高价值判断,哪些只是条款识别、风险标注、模板比对和初步修改建议。一旦这些动作被 Skill 化,客户会逐渐意识到,基础审查可以自动化,复杂交易里的商业背景、风险偏好、谈判位置和责任判断仍然需要律师。
未来真正值钱的,也就不会停留在“我会审合同”。更关键的是,一个律师或团队能否结合客户场景、交易结构和风险偏好,设计可复核、可交付、可沉淀的合同审查工作流。
三、更值得看的,是 MCP、API 和权威法源连接器
如果只盯着 “Skill” 这个词,很容易以为大家只是在 GitHub 上公开 prompt。本文研究里更有长期价值的部分,恰恰是 legal tooling、MCP server、API 和工作流连接器。
在这 12 个样本中,法律检索与 RAG、法源 API、MCP 数据接入占 3 个,实践管理连接器占 1 个。它们处理的是更底层的问题:法源怎么来,系统怎么接,权限怎么控,结果怎么留痕。法律 AI 的开源价值,也更多来自它能否接到权威法源、法规数据库、合同系统、案件系统、文档系统和律师事务所管理系统,并让输出结果进入可审计、可复核的工作链条。
一些看起来不太炫的项目,反而更接近生产环境。法律数据库 MCP、官方法源 API、判决检索服务器、Clio 这类 practice management connector,本质上都在解决同一个问题:让 AI 进入真实法律工作流。Legal Skill 开源潮真正有价值的部分,不只在 Skill 本身,也在围绕 Skill 建起来的法律 AI 基础设施。
四、这一波开源潮,很新
时间趋势也很明显。在能高置信推断创建季度的 9 个样本里,2025Q4 有 2 个,2026Q1 有 5 个,2026Q2 有 2 个;另外 3 个样本创建时间无法从公开页面高置信恢复。换句话说,这波法律 Skill 开源样本明显集中在最近几个季度。
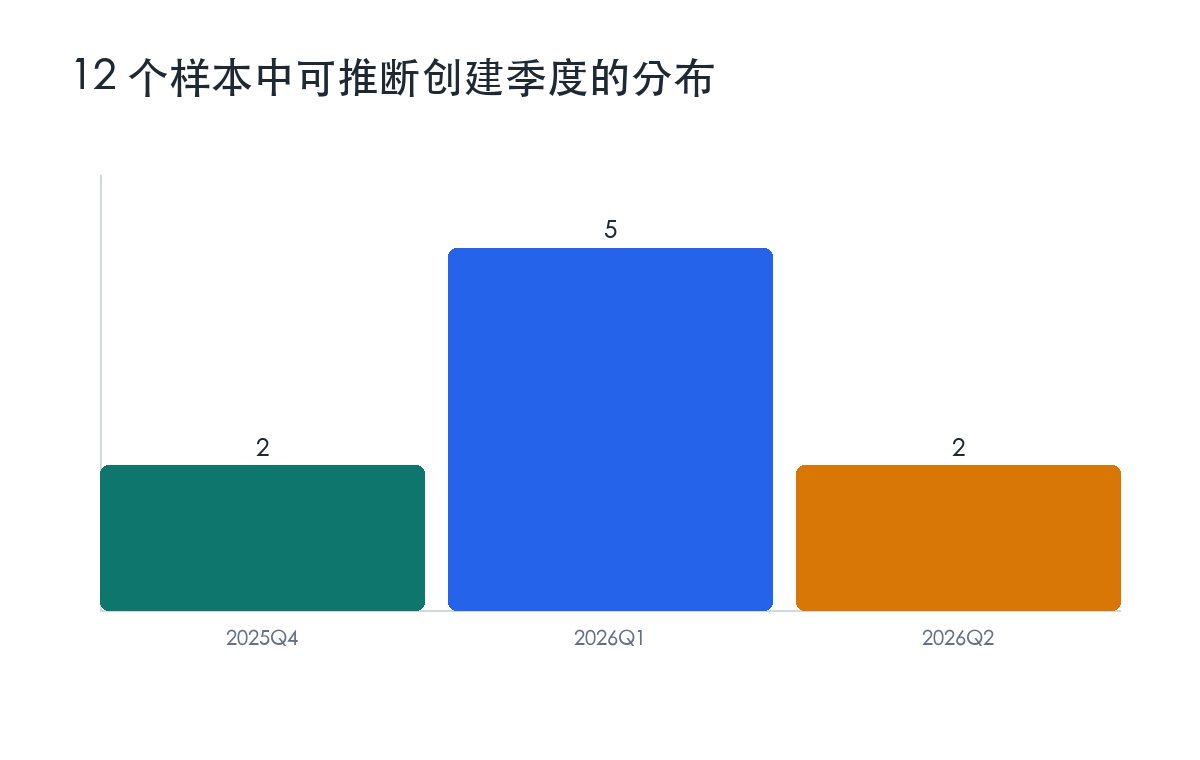
这不是一些多年以前的旧项目被重新发现。更像是最近几个月突然加速的一条支线。这个变化和 Claude Code、Agent Skills、MCP 等技术形态的流行有直接关系。过去法律 AI 更多是对话式助手,用户问一句,模型答一句;现在开始出现更工程化的形态:把任务拆成 Skill,把数据源封装成 MCP,把流程写成 workflow,把输出格式定义成结构化交付。
法律 AI 正在从“会回答问题”,走向“能进入工作流”。这个变化比单纯生成一份合同、总结一份判决,要深得多。
五、参与者已经很多元
如果只从法律圈短文的角度看,容易把这件事理解成“律师之间互相开源、互相秀肌肉”。从 GitHub 样本看,参与者结构要复杂得多。在 12 个高相关样本中,作者类型大致是:法律科技公司 4 个,独立开发者 3 个,律所或执业律师 3 个,政府或公共机构 1 个,其他或未定 1 个。
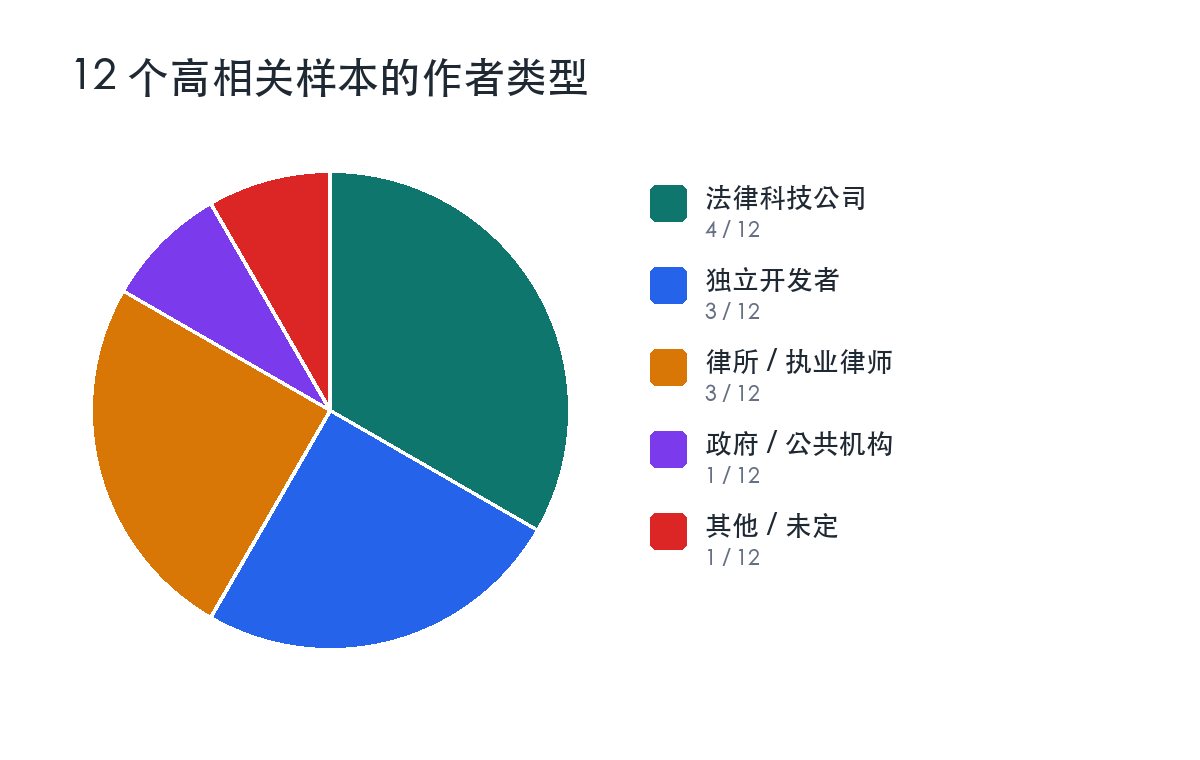
Legal Skill 开源并非单纯由律所推动。律师、独立开发者、法律科技公司、公共机构都在参与。未来的竞争也不会只发生在律师和律师之间,它还会发生在事务所方法论、法律科技产品、公共法源 API、开源社区和个人开发者之间。
过去,法律人的很多能力沉淀在个人经验、律所模板和项目交付里。现在,一部分能力开始被外化成代码、接口、规则、测试和工作流。谁能把这些东西做得更稳定、更可信、更容易集成,谁就可能获得新的话语权。
六、质量差异很大,不能把 GitHub 当成成品市场
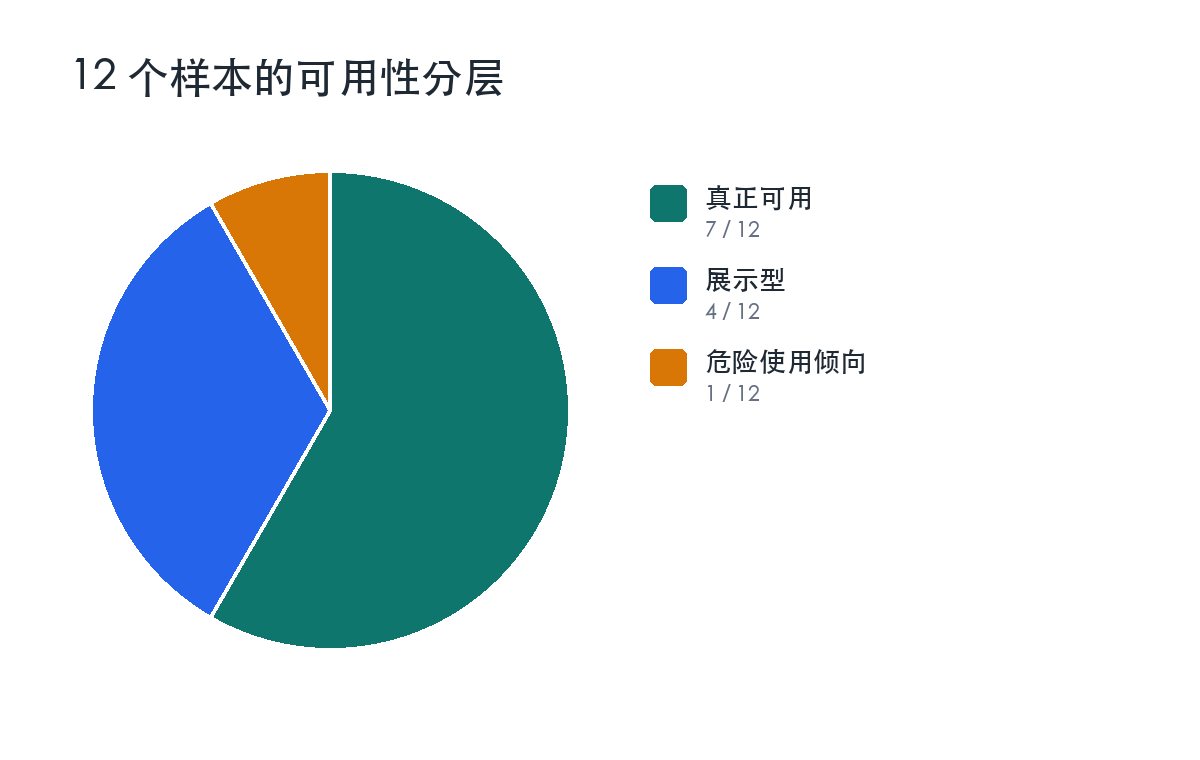
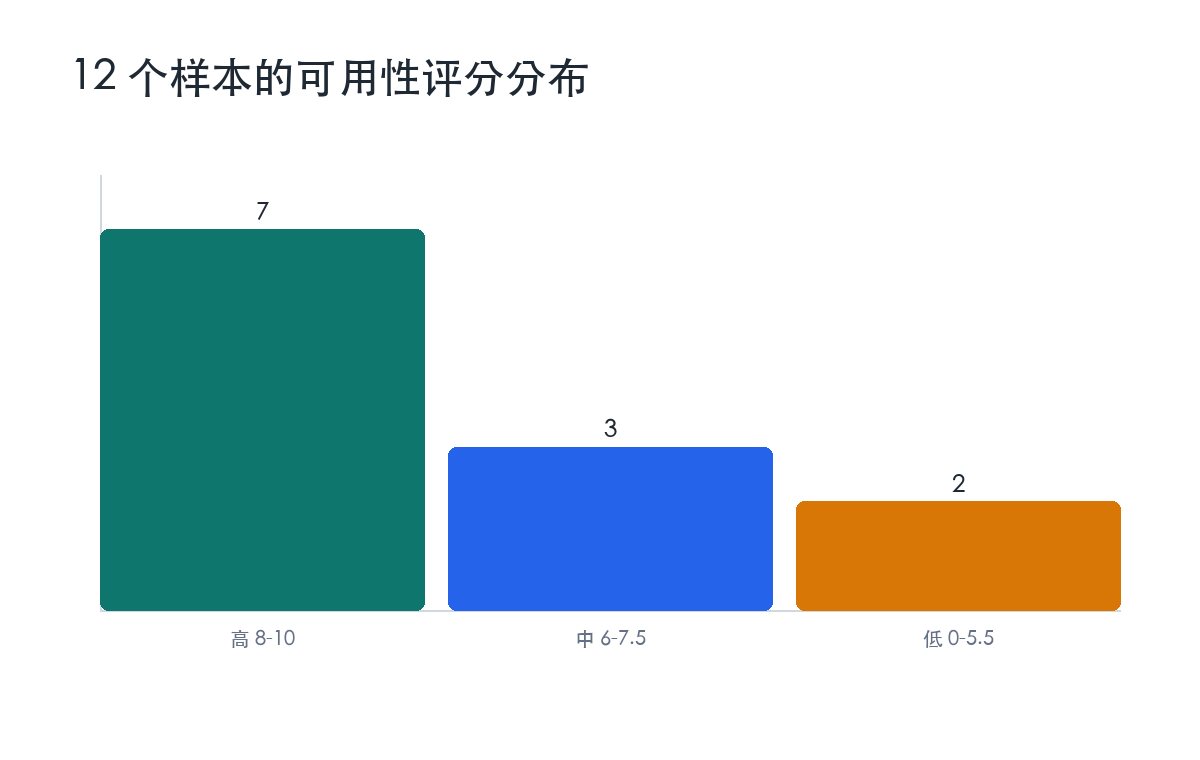
GitHub 上项目多,不代表都能用。本文研究里,一个非常明显的结论是:质量差异很大。在 12 个高相关样本中,按可用性评分,平均分约 7.4/10,中位数约 8/10。其中 7 个可以归入“真正可用”,4 个更接近“展示型”,还有 1 个属于“危险使用倾向”。
这里的“可用性”不看仓库热度,也不看 README 写得多漂亮,而是看它离真实法律工作流有多近。本文主要按七个维度打分:是否有清晰的安装或运行说明,是否存在可执行代码或配置,是否有输入输出示例或样本数据,是否有测试或 CI,是否有清晰许可证,是否有边界说明、免责声明或人工复核提示,以及是否能看到近期维护活动。
我把 8 到 10 分归为“真正可用”:这类项目不一定能直接进入生产环境,但至少有比较清楚的运行方式、边界提示和复核条件,适合在律师监督下试点。6 到 7.5 分归为“展示型”:它们通常有方法论价值或示范价值,但还缺少测试、许可证、完整运行链路或责任边界。低于 6 分,尤其是自动化承诺很强、但控制措施和边界说明明显不足的项目,则归为“危险使用倾向”。
真正有落地价值的项目,往往会体现出一些共同信号:权威数据源、审计日志、测试、运行说明、边界提示、人工复核、许可证和示例输入输出。相反,也有一些项目 README 写得很好看,stars 也不少,但公开页面里看不到足够的测试、许可证、适用边界或验收标准。
对于法律 AI 来说,这不是小问题。一个法律 Skill 至少应该说清楚:它适用于哪个法域,处理什么类型的法律任务,需要什么输入材料,输出什么格式的结果,哪些地方必须人工复核,有没有测试样例,有没有许可证,有没有明确说明不能替代法律意见。这些问题,比 stars 更重要。
七、开源 Skill 会改写法律服务的定价基础
本文研究让我最有感触的一点是,开源 Skill 不会复制一个完整律师,却会改写法律服务的定价基础。
过去,很多基础法律工作之所以可以收费,是因为它被包裹在专业服务里。客户并不清楚哪些环节是高价值判断,哪些环节只是检索、摘录、比对、格式整理、模板填充和初步风险标注。一旦这些工作被拆成 Skill、workflow、MCP 或 API,客户就会更容易看清楚:哪些法律工作是可重复的,哪些可以自动化,哪些仍然需要律师判断。
最容易被公共化的,是这些基础动作:合同条款识别、风险标签、红线建议、法规和案例检索、引用格式化、合规清单、DPIA 或 DPA 对照、隐私政策生成、判例摘要、裁判规则归纳、法规更新提醒,以及法律业务系统连接。
这些能力不会让律师消失,但会让法律服务发生分层。基础动作会越来越透明、越来越标准、越来越便宜。真正值钱的部分,会转移到客户事实、风险偏好、证据判断、谈判策略、组织流程、责任承担和系统集成上。法律 Skill 开源潮真正改写的,是哪些法律能力还值得单独收费。
八、法律人的能力,正在发生格式转换
如果把这波开源潮理解成“大家把秘籍拿出来互相卷”,其实还是浅了一层。更准确地说,法律人的能力正在发生格式转换。
过去,一个律师的能力主要存在于经验、案例、文章、模板和口头判断里。现在,一部分能力开始被外化成流程、规则、测试、知识库、Skill、MCP 和工作流。市场也会逐渐学会用新的方式观察专业能力:你能不能把经验拆成流程,能不能把流程写成规则,能不能让 AI 稳定执行一部分任务,能不能说明边界和风险,能不能留下审计记录,能不能把工具接入真实业务流程。
这才是法律 Skill 开源潮背后更深的变化。它会让法律人的专业能力变得更可见、更可比较,也更容易被系统化。这对法律人并不全是坏消息。它会迫使我们把“我有经验”翻译成更清楚的专业资产:我怎样定义问题,怎样拆分任务,怎样设置边界,怎样校验输出,怎样判断例外,怎样承担责任。
当基础动作开始公共化,真正稀缺的会是另一种能力:知道什么时候不该调用一个 Skill,什么时候必须停下来问事实,什么时候需要把模型输出推翻,什么时候要把问题升级为人的判断。
九、森林里开始有人修路了
法律 Skill 开源潮还在早期。GitHub 上的项目,有的是真正可用的基础设施,有的是有价值的方法论切片,也有不少只是演示项目。可无论如何,一个变化已经发生:法律工作中那些可重复、可拆解、可验证的部分,正在被写成可调用的能力单元。
这不会让律师瞬间被替代,也不会让一个开源仓库复制出完整的执业能力。它真正带来的变化,是让法律服务的底层结构变得更加透明。过去还能靠“我会检索”“我会审合同”“我会写模板”支撑的专业位置,未来会越来越难单独收费。因为这些能力正在被公共化、工具化、基础设施化。
真正的竞争会转向更高一层:谁能定义场景,谁能连接数据,谁能设计工作流,谁能设置边界,谁能承担责任,谁能把一次法律服务交付沉淀成可持续运行的系统。
法律 Skill 开源潮还没有让黑暗森林结束。只是森林里已经开始有人修路了。
后记:我的 GitHub 也会逐步发布开源 Skill
这件事我会继续观察,也会逐步把自己真实使用的一些 AI 工作流和 Skill 放到 GitHub 上。我的第一个开源 Skill 选择了一个更轻量的方向:AI 星辰电台播客生成 Skill。它用于把文章、研究材料或主题内容转化为适合播客表达的脚本和生成流程,也算是我把“内容生产工作流”拆成可复用 Skill 的一个开始。
项目链接:AI 星辰电台播客生成 Skill
https://github.com/The-Data-Galaxy/news-podcast-generator
后面,我也会继续尝试把数据合规、AI 合规、法律研究和内容生产中的一些可复用工作片段,逐步整理成开源 Skill。公开基础方法并不等于交出所有底牌。更重要的是,让一些可以复用的工作流先跑起来,和更多法律人、合规人、开发者一起迭代。
法律人的 Skill 开源时代,才刚刚开始。
说明:本文件为公众号渲染试稿,建议在浏览器中打开后复制渲染结果,再粘贴到公众号编辑器。