文 / Austin
GLM-5.3 作为最新亮相的国产头部模型,必须测一波法律任务表现。我把它和另一款更早时间火爆的头部模型 Kimi K3 拉到一起,在同一套合规调研评测框架下、使用同一个agent平台(WorkBuddy)、就同一个任务做了一次“同题 PK”:
任务:韩国个人数据出境要求分析(合规聚焦“对外提供 / 委托处理”场景)
本文把这次横评的方法、硬指标和四个维度的结论完整复盘,供同样在评估多款头部模型谁更适配法律任务的同行参考。
一、测试怎么设计的
为了让结果可比、可复现,我把变量压到最小:
- 同一套评测框架:运行相同的海外数据合规调研方法(即运行我的“海外数据合规调研”技能);
- 同一任务:韩国《个人信息保护法》(PIPA)项下个人数据出境时的合规要求,特别是对外提供与委托处理两类场景;
- 独立运行:两份报告各自独立生成,互不参考,避免“一个模型抄另一个”污染结论。
评测产出质量的,是四个标准:
- 覆盖范围:技能文件框架下要求的调研要点是否都被覆盖;
- 信源标注:引用的法规、官方译本是否按技能定义的文件层级清晰标注;
- 客观准确性:关键法律结论有没有硬伤;
- 额外输出:在在技能文件明确的要求之外,额外给出了哪些对读者有用的内容。
先看硬指标
先来看一些整体上定量的指标:
| 维度 | GLM-5.3 | Kimi K3 | 说明 |
|---|---|---|---|
| 任务耗时 | 12′20″ | 20′51″ | GLM-5.3 快约 41% |
| 消耗算力积分 | 178.48 | 426.78 | GLM-5.3 省约 58% |
| 报告字数 | 15,384 | 19,556 | K3 更详尽(多约 21% ) |
单看这张表,有一个初步的结论可以看到:在产出体量接近的前提下,GLM-5.3 用更少的时间和算力跑完了任务。K3 的报告更长,但字数差距(约 21%)远小于时间(约 41%)和算力(约 58%)的差距。这也和我一直以来使用K3的体感一致,K3确实是一款token消耗不少的模型。
三、四个维度逐项复盘
标准一:覆盖范围 —— 打平
框架要求覆盖两大块:
- 跨境传输(5 项):传输限制、传输法定基础、传输机制、安全评估要求、减退情形;
- 数据本地化(3 项):本地存储要求、存储位置要求、豁免情形。
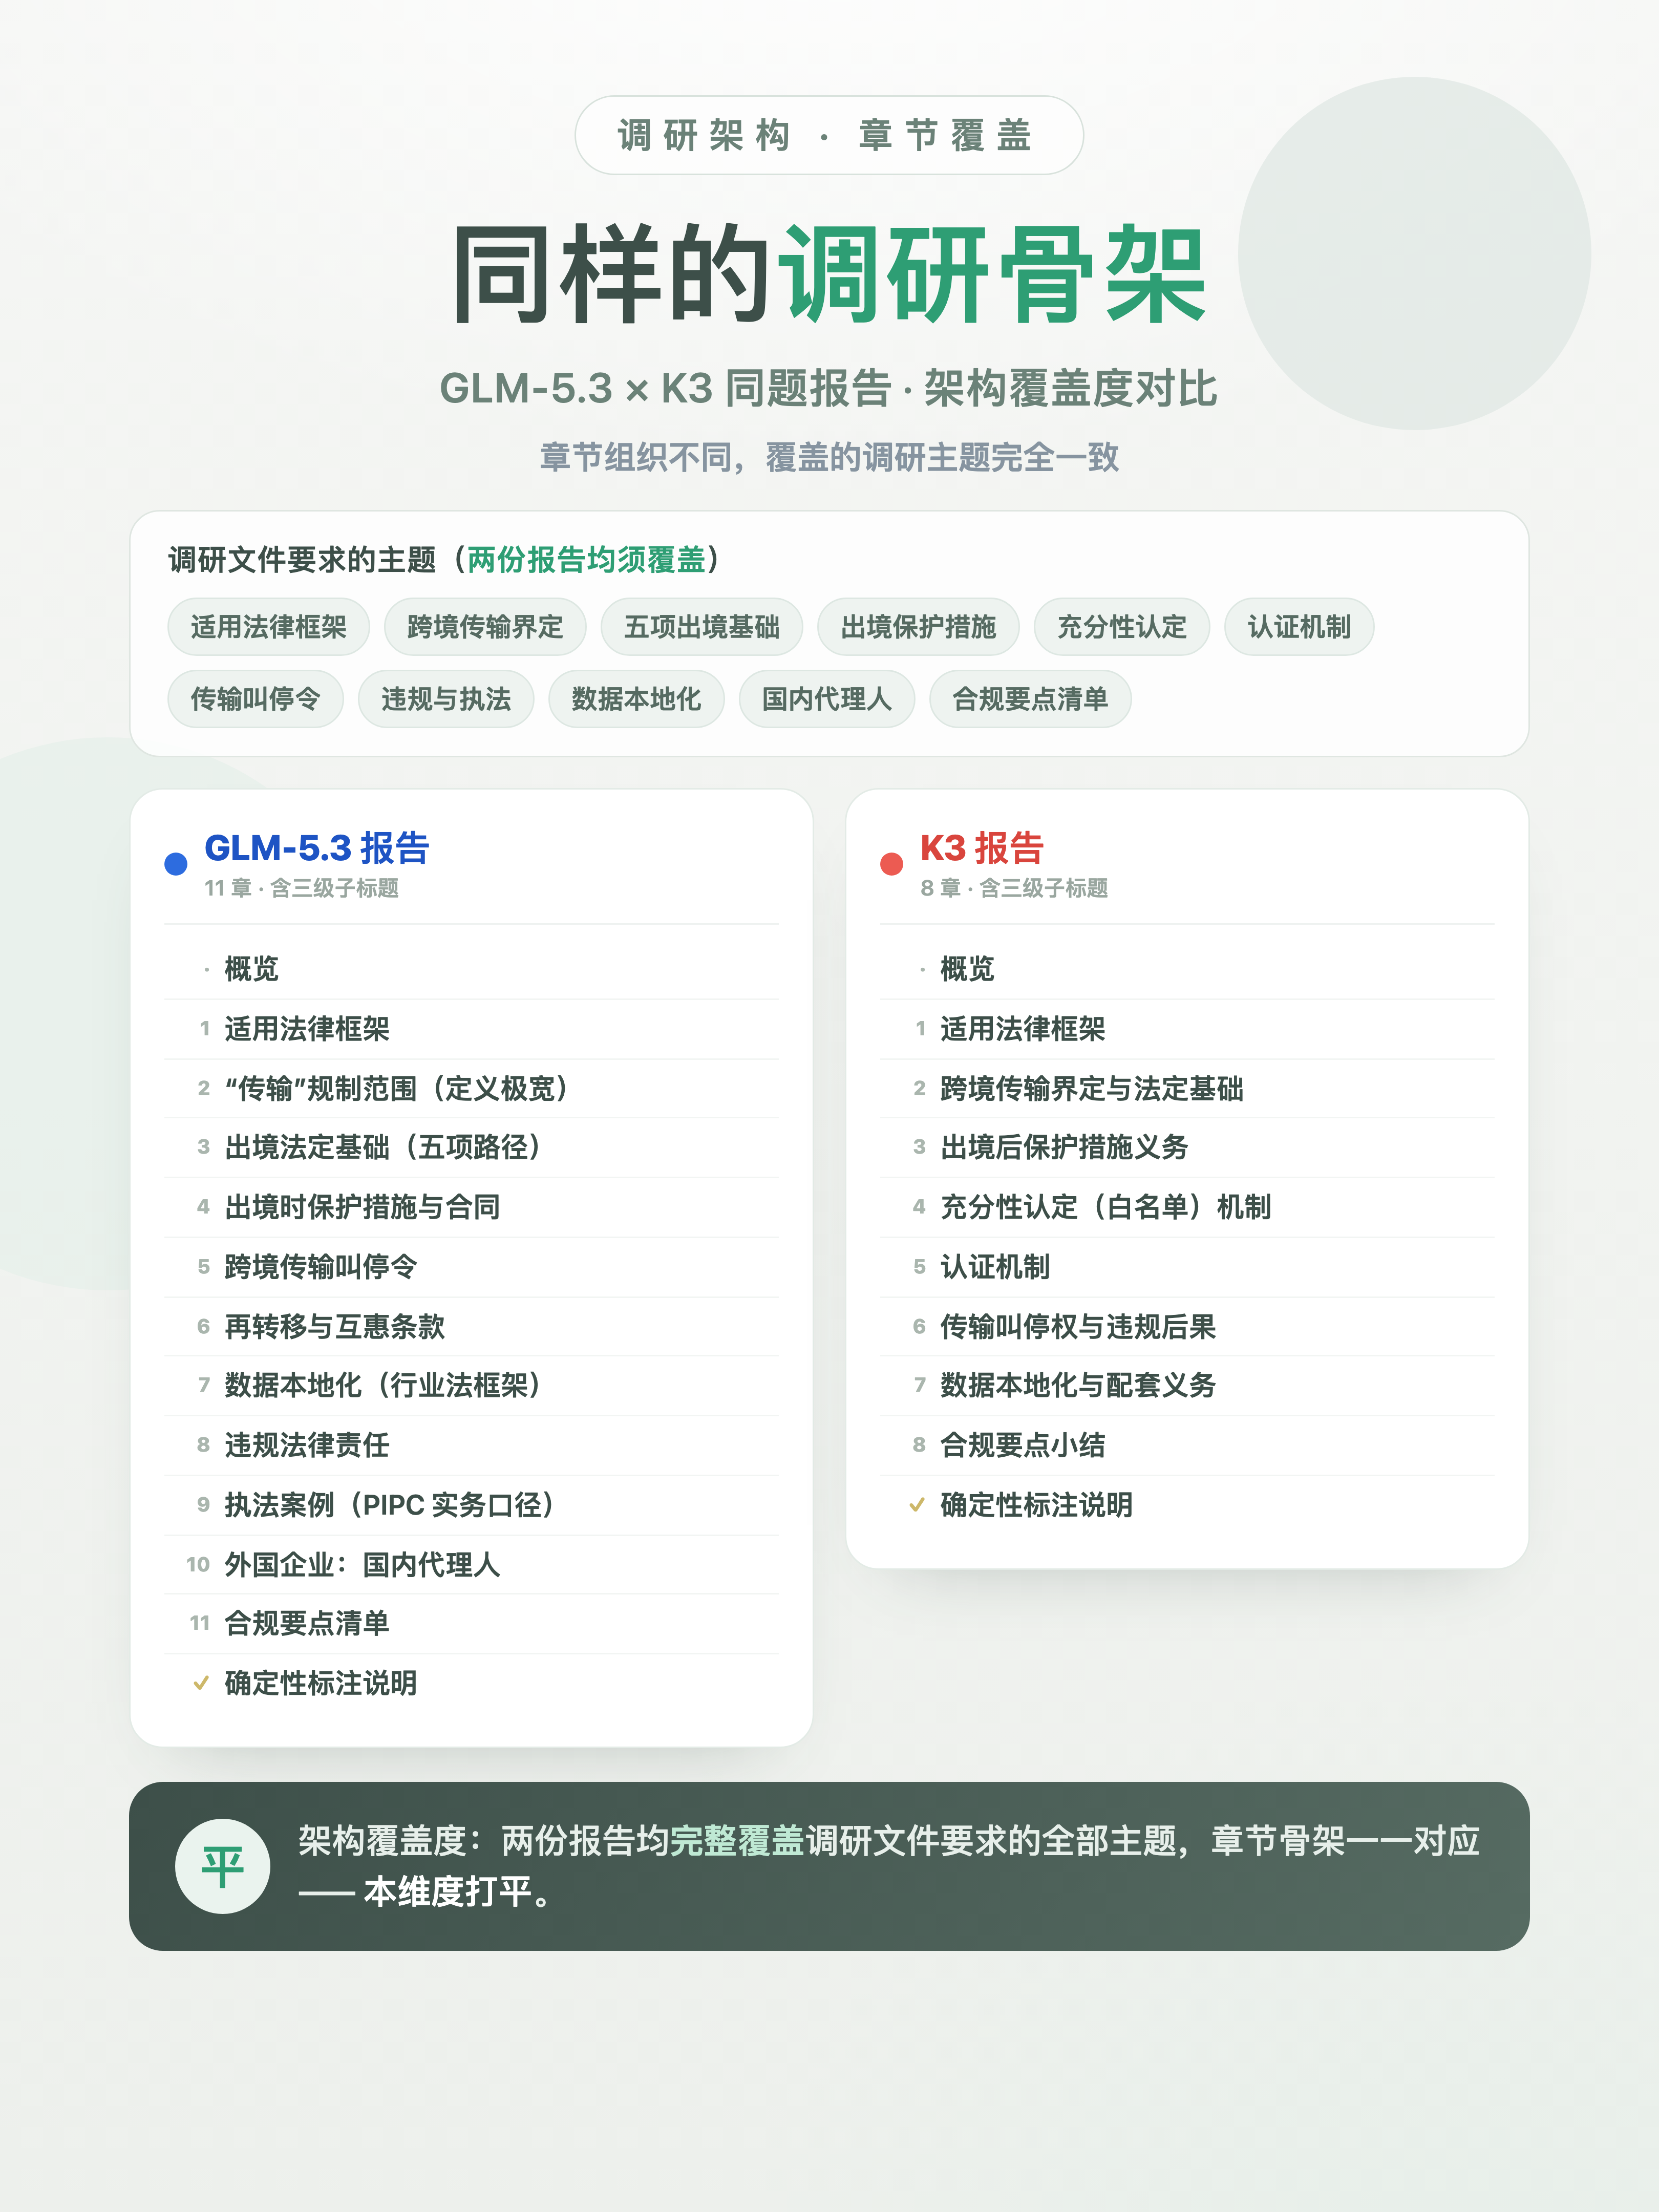
两份报告都把上述 8 项要点完整铺开,没有“该写没写”的缺口。这一维度,平。
标准二:信源标注 —— 打平
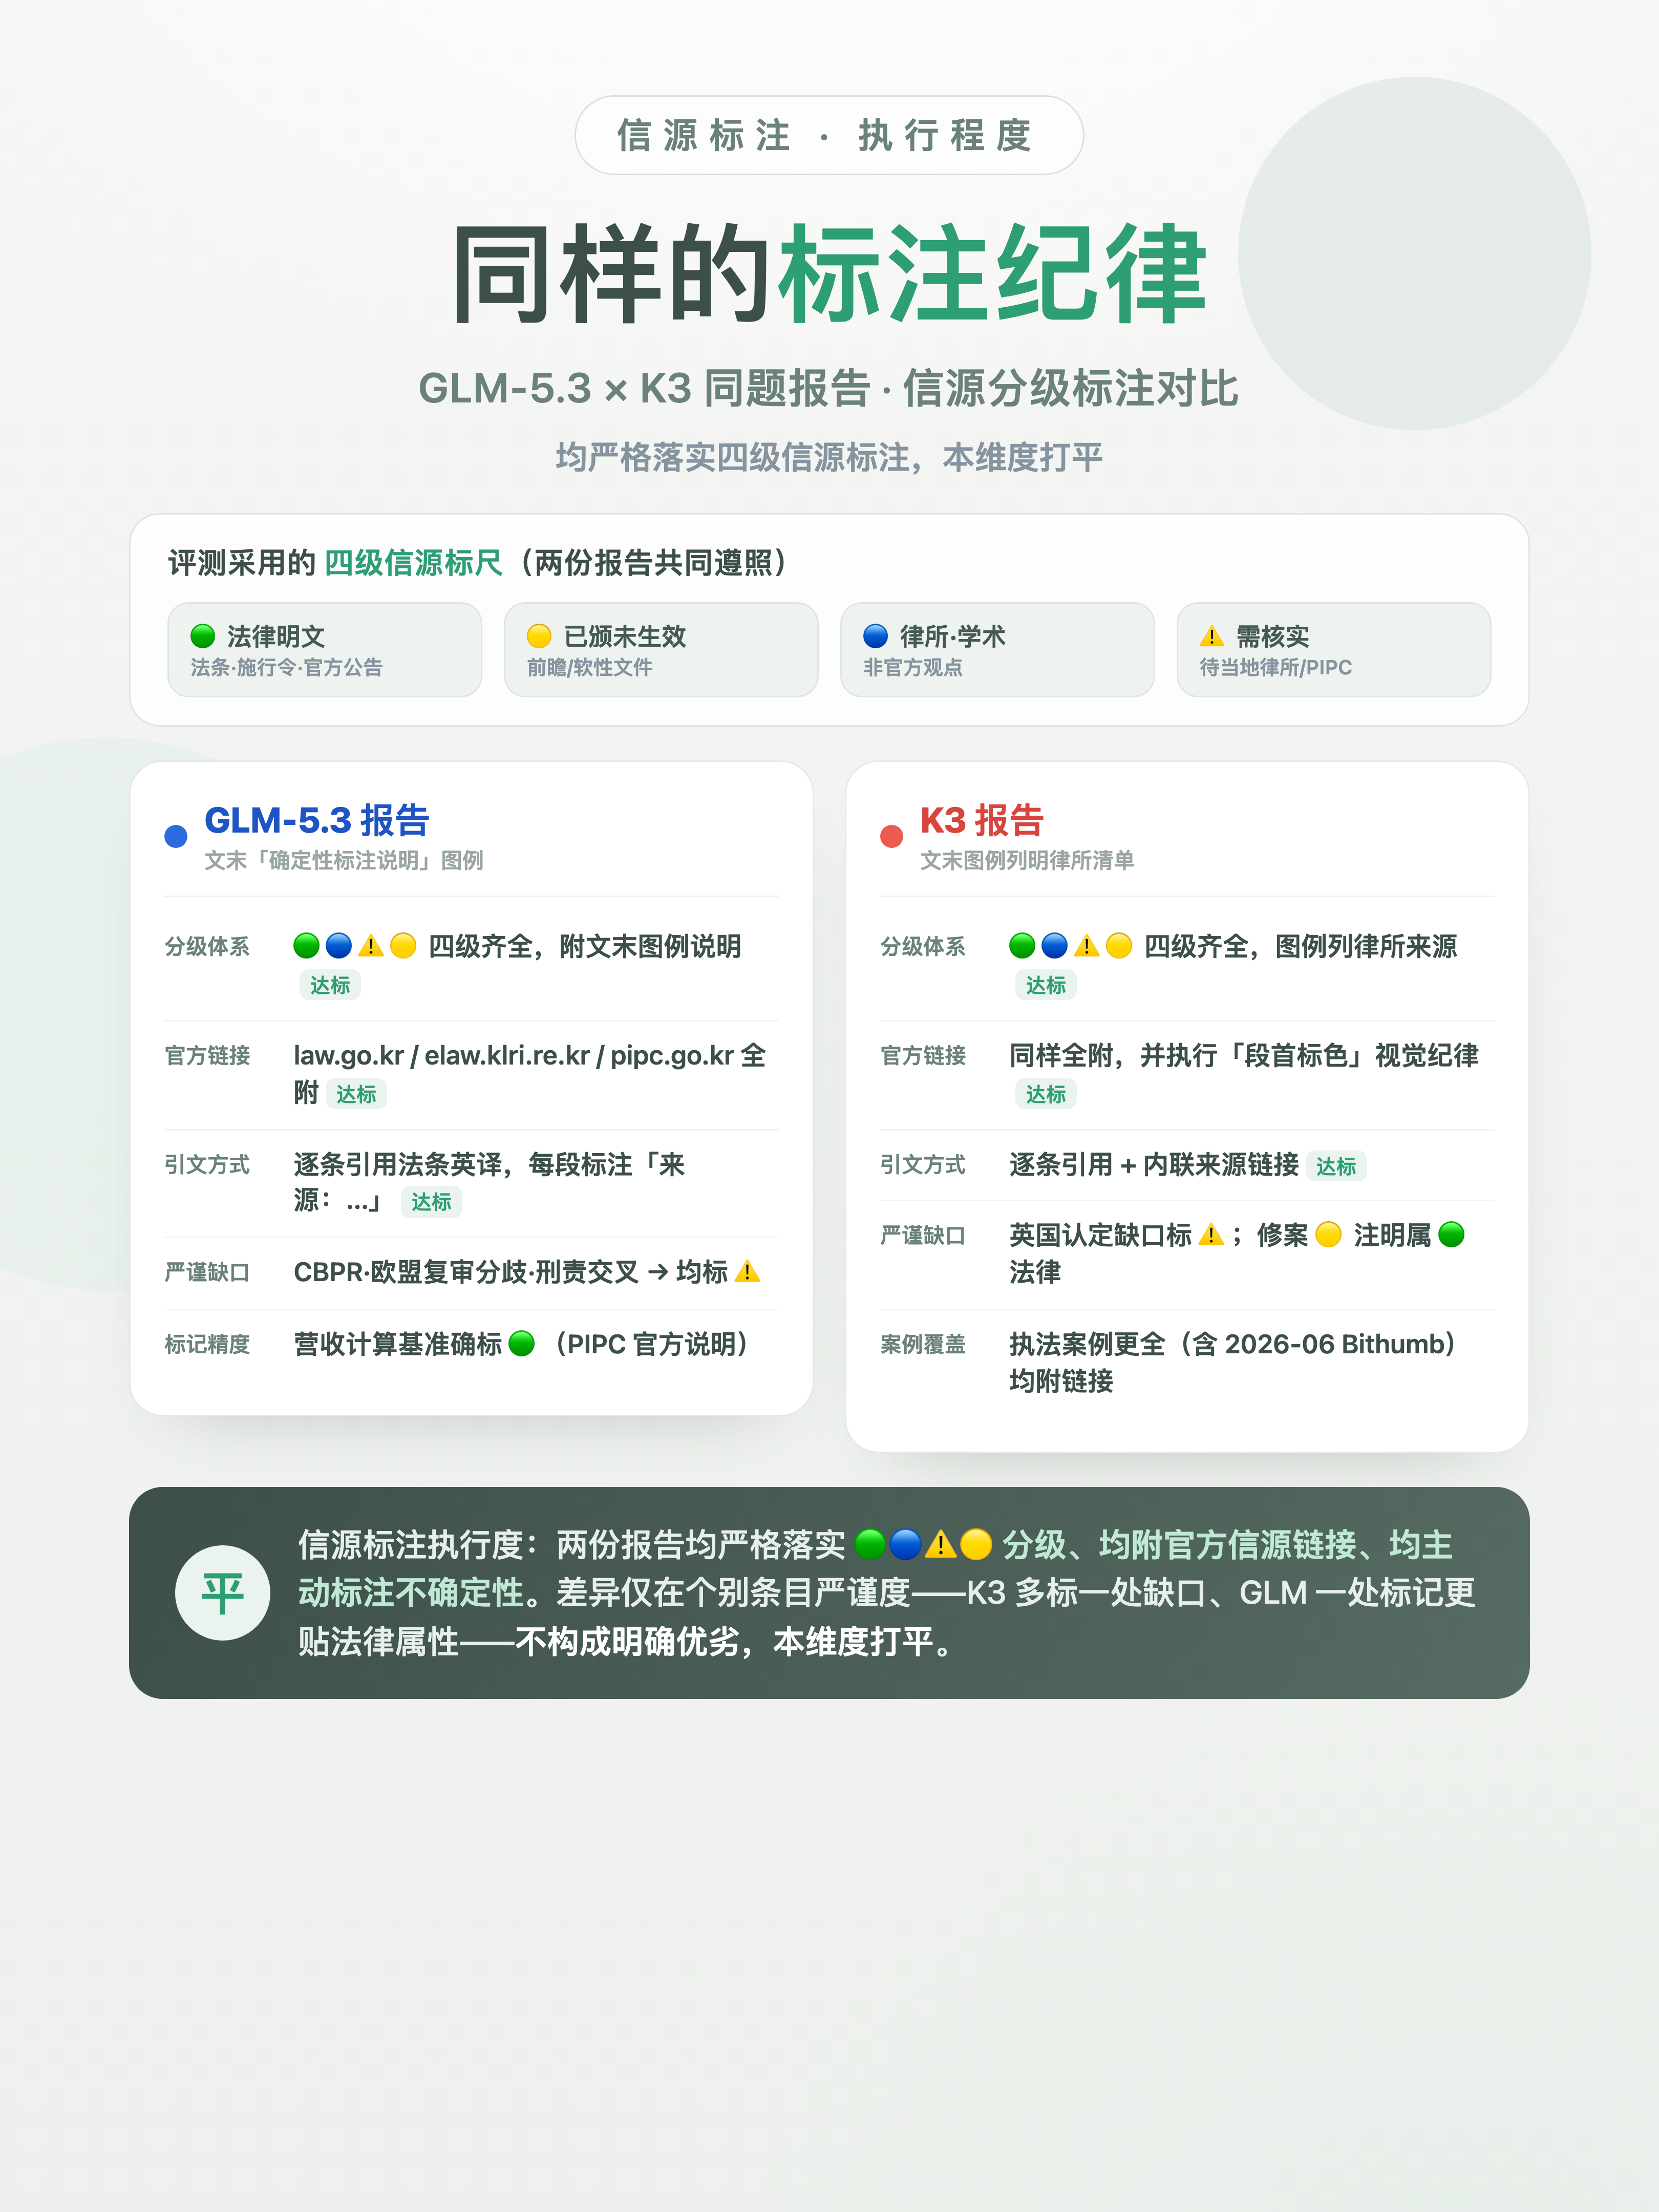
两份报告都严格执行了🟢法律明文 / 🟡已颁未生效 / 🔵律所·学术 / ⚠️需核实的四级信源标尺,且普遍附上了韩国法规官方出处(law.go.kr、PIPC、官方英译本)的链接。差异只在个别条目的严谨度上(例如对“英国充分性认定缺口”是否单独标⚠️,不构成明确优劣)。这一维度,平。
标准三:客观准确性 —— 打平
我们重点核验了两个最容易翻车的“坑”:
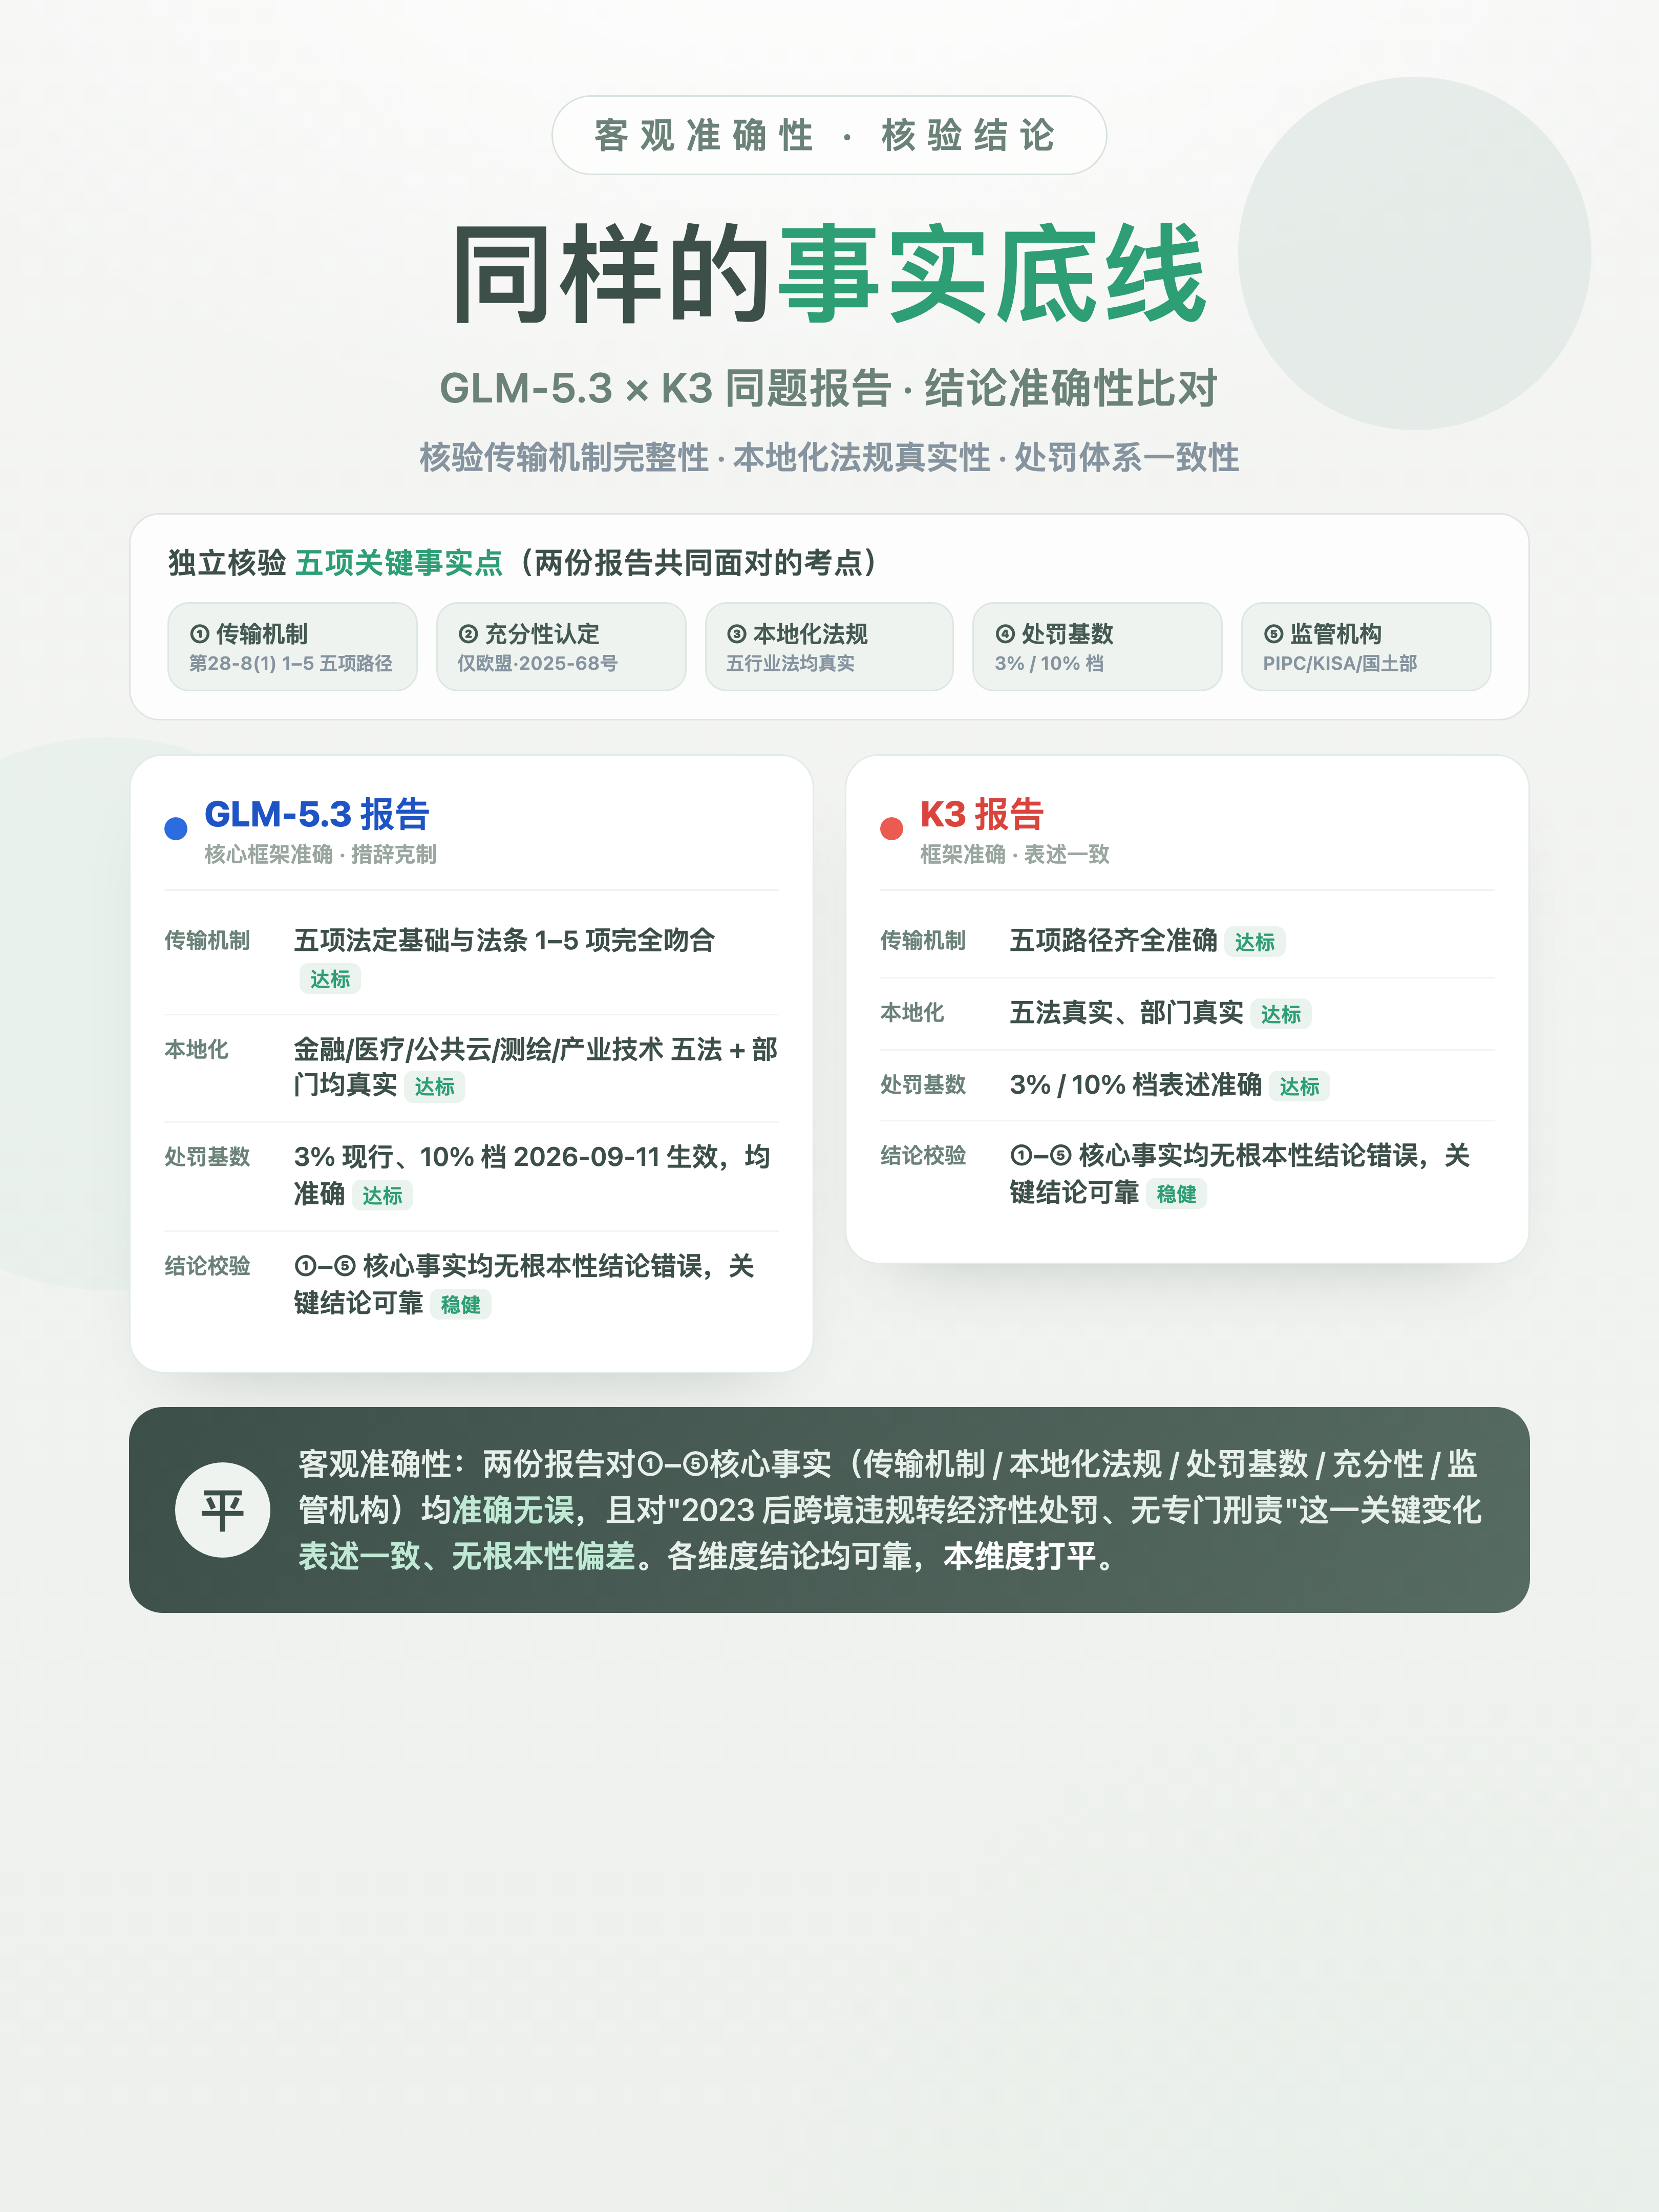
- 韩国跨境传输允许的机制是否齐全、表述准确:PIPA 第 28-8 条列明的五项机制(充分性认定、同意、合同保障、认证、其他法律依据),两份报告均完整对应、表述无误;
- 数据本地化涉及的法规与监管部门是否真实:电子金融交易法、医疗服务法、云计算振兴法、空间数据管理法、产业技术保护法,以及 PIPC、KISA、国土交通部长官等主体,均为真实存在的韩国法域要素。
值得一提的是“刑事责任”这一点。韩国 2023 年 PIPA 全面修订,取消了因未采取保护措施导致数据泄露的刑事处罚、整体转向经济性处罚;现行保留的刑责仅限于蓄意严重违法,并不因单纯的跨境传输违规触发。两份报告对此的把握均属准确——这一维度,平。
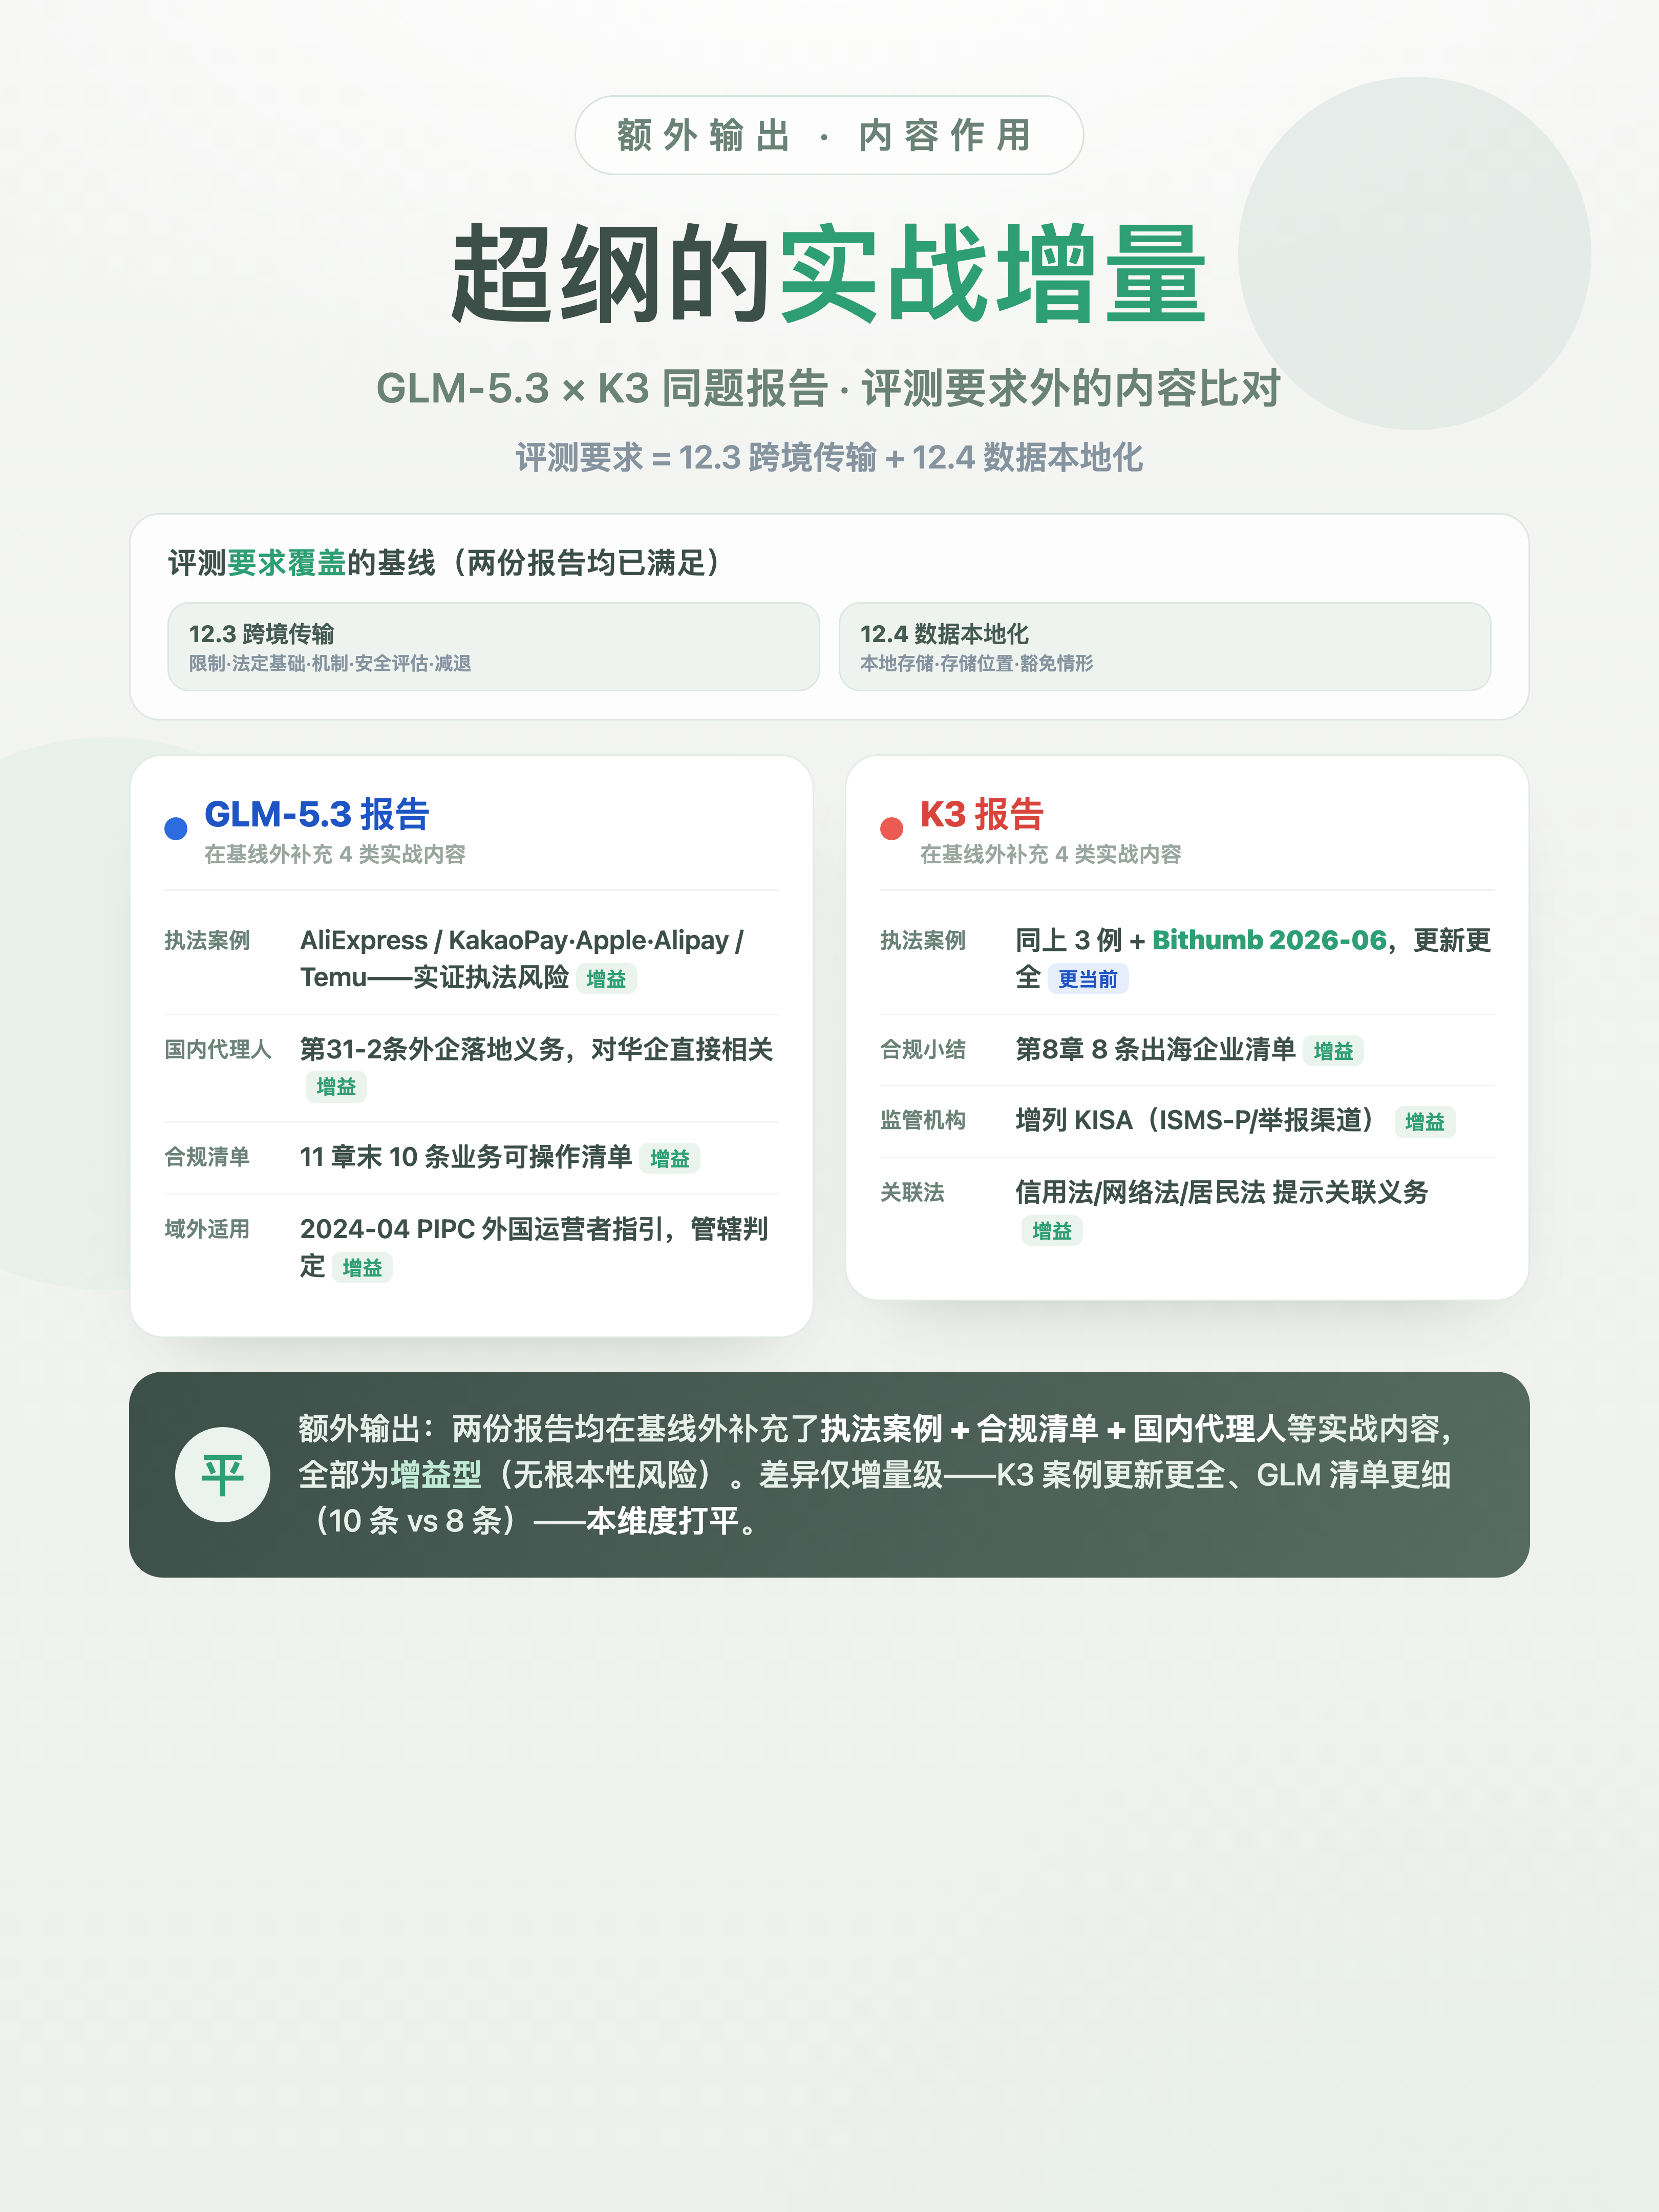
标准四:额外输出 —— 打平
两份报告都在“要求基线”之外,额外输出了对读者有实战价值的内容:执法案例(含较新的 PIPC 执法动向)、合规要点清单、国内代理人提示等。这些内容全部属于“增益型”产出,没有发现会误导读者的根本性风险。差异只在增量多少(K3 案例更新更全、GLM-5.3 清单更细),不构成优劣。这一维度,平。
结论:质量打平,性价比分出高下
在“产出质量”这一层,GLM-5.3 与 Kimi K3 基本打平。覆盖度、信源标注、客观准确性、额外输出都没有拉开明显差距。真正分出高下的,是性价比与速度:
- 同样的任务,GLM-5.3 耗时仅为 K3 的 59%;
- 消耗算力积分仅为 K3 的 42%;
- 报告字数仍达到 K3 的 79%。
换句话说:用不到一半的算力和六成的时间,GLM-5.3 交出了一份质量对等、仅略短的报告。对需要高频跑合规调研的法务团队而言,这种“单位成本产出”的差异,在长期复利下相当可观。
五、测评后的三点启示
- 测评方法轮上,模型横评要“同框架、同平台、同任务、独立跑”。不控制变量,结论就只是玄学。本次能得出一个相对客观的结论,靠的就是把评测框架和任务钉死。
- 质量打平的时代可能正在到来。随着大语言模型本身性能不断提升,也许他们在法律任务上也即将触碰到一个“阈值”。当头部模型在“专业法律任务”上都能稳定覆盖要点、准确标注信源、不犯硬伤时,选型的第一杠杆会从“谁更准”转向“谁更划算、谁更快”。
- 比起模型训练,智能体架构也许才是法律垂域的发力点。承接第2点,我们假设不久的将来,国产头部的通用大语言模型都处于可胜任法律任务的“智力状态”,那么接下来法律AI产品真正的发力点是否就在于agent架构的设计?同样的食材、同样的厨具,那么厨师的经验和临场发挥技巧就更为重要了。